
หลังบ้าน AI เป็นอย่างไร?
หลังบ้าน AI เป็นอย่างไร? เจาะลึกจาก Prompt หนึ่งบรรทัด สู่ GPU, Transformer, Inference และ Data Center ทุกวันนี้เราเปิดแอป AI พิมพ์คำถามว่...
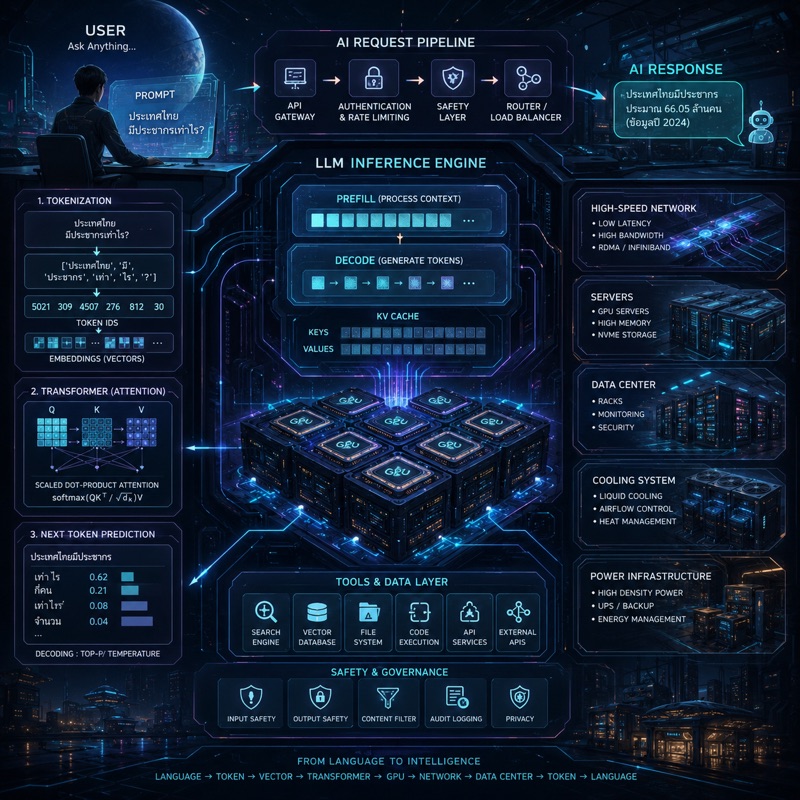
หลังบ้าน AI เป็นอย่างไร?
เจาะลึกจาก Prompt หนึ่งบรรทัด สู่ GPU, Transformer, Inference และ Data Center
ทุกวันนี้เราเปิดแอป AI พิมพ์คำถามว่า “ช่วยวิเคราะห์เรื่องนี้ให้หน่อย” แล้วเพียงไม่กี่วินาทีก็ได้รับคำตอบที่ดูเหมือนกำลังสนทนากับมนุษย์
แต่สิ่งที่ปรากฏบนหน้าจอเป็นเพียง Front-end หรือส่วนที่เราเห็นเท่านั้น
หลังคำตอบไม่กี่ย่อหน้า มีระบบขนาดใหญ่ซ่อนอยู่ ตั้งแต่การรับคำขอผ่านเครือข่าย การตรวจสอบสิทธิ์ การเลือกโมเดล การแปลงภาษาเป็นตัวเลข การคำนวณบน GPU จำนวนมหาศาล การเข้าถึงเครื่องมือและข้อมูลภายนอก ไปจนถึงระบบความปลอดภัยและโครงสร้างพื้นฐานของ Data Center
ถ้าจะอธิบายให้สั้นที่สุด
AI ที่เราเห็นคือหน้าต่างเล็ก ๆ ที่เปิดเข้าสู่โรงงานคำนวณขนาดมหึมา
และนี่คือสิ่งที่เกิดขึ้นใน “หลังบ้าน AI”
🧠 1. AI ไม่ได้เก็บคำตอบทุกคำถามเอาไว้
ความเข้าใจผิดอย่างหนึ่งคือ AI มีฐานข้อมูลคำตอบขนาดมหึมา และเมื่อเราถามอะไร ระบบก็เพียงค้นหาคำตอบที่เก็บไว้แล้วส่งกลับมา
สำหรับ Large Language Model หรือ LLM กลไกหลักไม่ได้ทำงานแบบนั้น
โมเดลผ่านการฝึกจากข้อมูลจำนวนมหาศาลเพื่อปรับค่าตัวเลขภายในที่เรียกว่า Parameters หรือ Weights
Parameters เหล่านี้อาจมีจำนวนตั้งแต่หลายพันล้านไปจนถึงระดับที่ใหญ่มาก ขึ้นอยู่กับสถาปัตยกรรมของแต่ละโมเดล
สิ่งที่ถูกเก็บไว้จึงไม่ใช่ “หนังสือทั้งเล่ม” หรือ “คำตอบสำเร็จรูปทุกคำถาม” แต่เป็นรูปแบบทางคณิตศาสตร์ที่โมเดลได้เรียนรู้จากข้อมูล
เมื่อเราส่ง Prompt เข้าไป ระบบจึงต้อง คำนวณคำตอบขึ้นมาใหม่ในขณะนั้น
นี่คือกระบวนการที่เรียกว่า Inference
🔤 2. ก่อน AI เข้าใจภาษา มันต้องเปลี่ยนภาษาเป็น Token
สมมติเราพิมพ์ว่า
“ประเทศไทยมีประชากรเท่าไร”
คอมพิวเตอร์ไม่ได้ประมวลผลประโยคนี้ในความหมายแบบเดียวกับมนุษย์โดยตรง
ข้อความจะถูกส่งเข้าสู่กระบวนการ Tokenization
ประโยคถูกแบ่งออกเป็นหน่วยย่อยที่เรียกว่า Token
Token ไม่จำเป็นต้องเท่ากับหนึ่งคำเสมอไป อาจเป็นคำ ส่วนของคำ เครื่องหมาย หรือหน่วยอื่นตาม tokenizer ของโมเดล
จากนั้นแต่ละ Token จะถูกแปลงเป็นหมายเลข และต่อไปเป็นเวกเตอร์ทางคณิตศาสตร์
เส้นทางโดยย่อจึงเป็น
ภาษา → Token → Token ID → Vector → Neural Network
นับจากจุดนี้ สิ่งที่เราเรียกว่า “ภาษา” กำลังถูกประมวลผลในรูปของคณิตศาสตร์แล้ว
🧩 3. Transformer คือเครื่องยนต์สำคัญของ LLM
สถาปัตยกรรมที่มีอิทธิพลอย่างมากต่อ Generative AI ยุคปัจจุบันคือ Transformer
แนวคิดสำคัญคือกลไกที่เรียกว่า Attention
มันช่วยให้โมเดลพิจารณาความสัมพันธ์ระหว่าง Token ต่าง ๆ ในบริบท
เช่น
“สมชายซื้อรถใหม่ เพราะรถคันเก่าของเขาเสีย”
เมื่อประมวลผลคำว่า “เขา” โมเดลต้องอาศัยบริบทก่อนหน้าเพื่อประเมินว่าคำดังกล่าวสัมพันธ์กับอะไร
ในเชิงเทคนิค Attention มักอธิบายผ่านองค์ประกอบ
Query (Q)
Key (K)
Value (V)
และรูปแบบพื้นฐานของ Scaled Dot-Product Attention คือ
Attention(Q,K,V) = softmax(QKᵀ / √dₖ)V
สิ่งที่ดูเหมือน AI “เข้าใจว่าประโยคกำลังพูดถึงอะไร” จึงมีฐานสำคัญมาจากการคำนวณความสัมพันธ์ของ representation ภายในโมเดล
🎯 4. หัวใจอีกด้านของ LLM คือการทำนาย Token ถัดไป
ลองให้ประโยคว่า
“กรุงเทพมหานครเป็นเมืองหลวงของ…”
โมเดลจะคำนวณความน่าจะเป็นของ Token ที่สามารถเกิดขึ้นต่อไป
เช่น ในเชิงแนวคิด
ประเทศไทย → 0.91
ญี่ปุ่น → 0.02
จีน → 0.01
อื่น ๆ → 0.06
จากนั้นระบบเลือก Token ตามกลยุทธ์การถอดรหัสหรือ Decoding
เมื่อได้ Token ใหม่แล้ว มันจะถูกเพิ่มเข้าไปในบริบท ก่อนคำนวณ Token ถัดไปอีกครั้ง
กระบวนการจึงคล้าย
Input → Predict → Token → Predict → Token → Predict → Token…
วนต่อไปจนกระทั่งได้คำตอบสมบูรณ์หรือถึงเงื่อนไขหยุด
นี่คือเหตุผลหนึ่งที่เราเห็นข้อความจาก AI ค่อย ๆ ปรากฏออกมาเป็นลำดับ
⚙️ 5. Prefill และ Decode — สองช่วงสำคัญของ Inference
ถ้าเจาะลงไปอีกระดับ การประมวลผล LLM สามารถมองเป็นสองช่วงสำคัญ
Prefill
ระบบประมวลผล Prompt และ Context ที่ส่งเข้ามาทั้งหมด
หากเราส่งเอกสารยาวมาก Context ก็ยิ่งมาก และต้องใช้ทรัพยากรในการประมวลผลเพิ่มขึ้น
Decode
หลังจากเข้าใจ representation ของบริบทแล้ว ระบบเริ่มสร้าง Token ใหม่ทีละ Token
ตรงนี้มีข้อจำกัดสำคัญคือ Token รุ่นหลังต้องพึ่งพา Token ที่เกิดขึ้นก่อนหน้า
ดังนั้นการสร้างคำตอบ 1,000 Token ไม่เหมือนกับการคำนวณ 1,000 งานที่ไม่เกี่ยวข้องกันพร้อมกันทั้งหมด
นี่เป็นโจทย์สำคัญของการทำให้ AI ตอบเร็ว
🚀 6. KV Cache — หน่วยความจำที่ช่วยไม่ให้ AI คำนวณซ้ำทั้งหมด
หากทุกครั้งที่สร้าง Token ใหม่ โมเดลต้องคำนวณ Attention ของข้อมูลเดิมทั้งหมดตั้งแต่ต้น ระบบจะสิ้นเปลืองอย่างมาก
จึงมีเทคนิคสำคัญที่เรียกว่า
KV Cache
ระบบเก็บ Key และ Value จาก Token ก่อนหน้าเอาไว้ เพื่อให้ขั้นตอน Decode สามารถนำผลเดิมกลับมาใช้
ผลคือการสร้าง Token ถัดไปเร็วขึ้นมาก
แต่สิ่งที่แลกมาคือ
KV Cache กินหน่วยความจำ
เมื่อ Context ยาว จำนวนผู้ใช้งานพร้อมกันมาก หรือโมเดลมีขนาดใหญ่ การบริหารหน่วยความจำจึงกลายเป็นโจทย์ระดับ Infrastructure
AI จึงไม่ได้แข่งขันกันเพียงว่า “ใครมีโมเดลฉลาดกว่า”
แต่ยังแข่งขันว่า
ใครบริหาร Compute และ Memory ได้มีประสิทธิภาพกว่า
🖥️ 7. ทำไม AI ถึงต้องใช้ GPU?
Neural Network ต้องทำการคำนวณ Matrix และ Vector จำนวนมหาศาล
GPU มีสถาปัตยกรรมที่เหมาะกับงาน Parallel Computing ประเภทนี้
จึงเกิด Stack ทางเทคนิคประมาณว่า
AI Application
↓
Inference Framework / Runtime
↓
GPU Software Stack
↓
GPU Accelerator
↓
Server
↓
Rack
↓
Data Center
เมื่อผู้ใช้หลายล้านคนถาม AI พร้อมกัน สิ่งที่เกิดขึ้นเบื้องหลังคือระบบต้องกระจาย workload ไปยัง accelerator จำนวนมากอย่างมีประสิทธิภาพ
ดังนั้น AI ไม่ได้เป็นเพียง Software
มันคือการบรรจบกันของ
Software + Model + Semiconductor + Networking + Storage + Power + Cooling + Data Center
🏭 8. โมเดลขนาดใหญ่อาจไม่สามารถอยู่บน GPU ตัวเดียว
เมื่อโมเดลมีขนาดใหญ่ Parameters และข้อมูลระหว่างการคำนวณอาจเกินความจุของ accelerator เพียงตัวเดียว
จึงต้องมีเทคนิค Distributed Computing หลายรูปแบบ เช่น
Tensor Parallelism
แบ่งการคำนวณภายใน operation ของโมเดลออกไปยัง GPU หลายตัว
Pipeline Parallelism
แบ่ง Layer ของโมเดลเป็นช่วง ๆ แล้วให้ accelerator แต่ละกลุ่มรับผิดชอบคนละช่วง
Data Parallelism
สร้างสำเนา workload/model เพื่อประมวลผลข้อมูลหลายชุดพร้อมกัน โดยเฉพาะในงานฝึกโมเดล
สำหรับโมเดลบางประเภท ยังมีแนวคิดอย่าง
Mixture of Experts (MoE)
แทนที่จะให้ทุกส่วนของโมเดลทำงานกับทุก Token ระบบสามารถเลือกใช้ Expert บางส่วนตามความเหมาะสม
แนวคิดคือเพิ่มความสามารถของโมเดลโดยไม่จำเป็นต้อง activate parameters ทั้งหมดสำหรับทุก Token
🌐 9. Network กลายเป็นส่วนหนึ่งของ “เครื่อง AI”
เมื่อโมเดลทำงานบน GPU หลายตัว ปัญหาจะไม่ได้อยู่แค่ความเร็วของ GPU
GPU ต้องแลกเปลี่ยนข้อมูลระหว่างกันด้วย
หาก accelerator เร็วมากแต่ Network ช้า ระบบก็ต้องรอข้อมูล
Data Center สำหรับ AI จึงต้องให้ความสำคัญกับ High-Speed Interconnect และเครือข่ายที่มี
- Bandwidth สูง
- Latency ต่ำ
- การเชื่อมต่อระหว่าง accelerator ที่มีประสิทธิภาพ
- Network topology ที่เหมาะกับ workload
ในระบบ AI ขนาดใหญ่ เส้นแบ่งระหว่าง “คอมพิวเตอร์หนึ่งเครื่อง” กับ “Data Center” จึงเริ่มเลือนลง
เพราะ accelerator จำนวนมากสามารถถูกออกแบบให้ทำงานร่วมกันเสมือนเป็นเครื่องคำนวณขนาดมหึมา
🛣️ 10. เมื่อเรากด Send คำถามเดินทางไปไหน?
ในบริการ AI จริง ระบบมักซับซ้อนกว่าการส่งข้อความตรงเข้าโมเดล
ภาพอย่างง่ายอาจเป็น
User
↓
Application / Web / Mobile
↓
API Gateway
↓
Authentication + Rate Limiting
↓
Safety / Request Processing
↓
Router / Load Balancer
↓
Model Serving Infrastructure
↓
GPU Cluster
↓
LLM Inference
↓
Post-processing / Safety
↓
Streaming Response
↓
User
Router มีความสำคัญมาก เพราะระบบต้องตัดสินใจว่าจะส่ง Request ไปที่ไหน
อาจพิจารณาเรื่อง
- โมเดลที่เหมาะสม
- จำนวน GPU ที่ว่าง
- Latency
- ภูมิภาคของ Server
- ต้นทุน
- ความหนาแน่นของ Traffic
- ความสามารถที่ผู้ใช้ร้องขอ
AI ระดับ Production จึงมีปัญหาแบบเดียวกับระบบ Cloud ขนาดใหญ่ เพียงแต่ workload มีความต้องการ Compute และ Memory สูงมากเป็นพิเศษ
📦 11. Batching — รวมคำขอเพื่อใช้ GPU ให้คุ้มขึ้น
ลองจินตนาการว่ามีผู้ใช้ 1,000 คนถาม AI ในเวลาใกล้เคียงกัน
หากสร้างกระบวนการแยกแบบไม่มีการจัดการเลย ประสิทธิภาพของ GPU อาจไม่ดีที่สุด
Inference Server จึงสามารถนำ Request หลายรายการมาจัดกลุ่มเพื่อประมวลผลอย่างมีประสิทธิภาพ
เรียกว่า Batching
แต่คำถามคือ
ถ้ารอสะสม Request มากเกินไป → GPU อาจถูกใช้คุ้มขึ้น แต่ผู้ใช้รอนาน
ถ้า Batch เล็กเกินไป → ตอบเร็ว แต่ Hardware utilization อาจต่ำ
นี่จึงเป็นการหาสมดุลระหว่าง
Throughput ↔ Latency
และเป็นหนึ่งในโจทย์สำคัญของระบบ AI หลังบ้าน
🧰 12. AI ยุคใหม่ไม่ได้มีเพียง Model แต่มี Tools
สิ่งที่เราเรียกว่า AI Assistant ในปัจจุบันอาจไม่ได้ใช้ LLM เพียงอย่างเดียว
เมื่อเราสั่งว่า
“ค้นหาข้อมูลล่าสุดแล้วสรุปให้ฉัน”
โมเดลอาจต้องตัดสินใจเรียก Search Tool
ถ้าสั่ง
“วิเคราะห์ไฟล์ Excel นี้”
อาจต้องเรียกเครื่องมือประมวลผลไฟล์หรือ Code Execution
ถ้าสั่ง
“สร้างรูปภาพ”
ระบบอาจส่งงานไปยังโมเดลสร้างภาพ
ดังนั้นสถาปัตยกรรมสมัยใหม่จึงเริ่มมีลักษณะ
User → AI Orchestrator → Model → Tool → Data → Model → Answer
LLM จึงเริ่มทำหน้าที่มากกว่า “เครื่องสร้างข้อความ”
มันกลายเป็น Reasoning/Orchestration Layer ที่เชื่อมมนุษย์เข้ากับ Software และข้อมูลหลายประเภท
📚 13. RAG — เมื่อ AI ต้องใช้ข้อมูลที่ไม่ได้อยู่ใน Parameters
สมมติองค์กรมีเอกสารภายใน 100,000 ฉบับ
เราไม่จำเป็นต้อง Train โมเดลใหม่ทุกครั้งที่เอกสารเปลี่ยน
สามารถใช้แนวคิด
Retrieval-Augmented Generation (RAG)
กระบวนการโดยย่อคือ
User Question
↓
สร้าง representation / Search Query
↓
ค้นฐานข้อมูลหรือ Vector Database
↓
ดึงข้อมูลที่เกี่ยวข้อง
↓
ใส่ข้อมูลเข้าสู่ Context
↓
LLM สร้างคำตอบจาก Context
ดังนั้นความสามารถของระบบ AI ในองค์กรจึงไม่ได้ขึ้นอยู่กับ LLM เพียงอย่างเดียว
คุณภาพของ
Search + Retrieval + Ranking + Data Quality + Context Construction
มีผลต่อคุณภาพคำตอบอย่างมาก
🛡️ 14. Safety Layer — สิ่งที่อยู่รอบโมเดล
ระบบ AI ที่เปิดให้คนจำนวนมากใช้งานจำเป็นต้องมีมาตรการหลายชั้น
ตัวอย่างเช่น
Input Safety
ตรวจสอบคำขอก่อนเข้าสู่กระบวนการบางประเภท
Output Safety
ประเมินผลลัพธ์ก่อนหรือระหว่างส่งกลับ
Authentication
ตรวจสอบว่าใครเป็นผู้ใช้งาน
Authorization
ผู้ใช้นั้นมีสิทธิ์เข้าถึงข้อมูลหรือ Tool ใด
Rate Limiting
ป้องกันการใช้ระบบเกินข้อจำกัด
Logging / Monitoring
ตรวจสอบความผิดปกติและประสิทธิภาพระบบ
Isolation
แยก environment สำหรับงานที่อาจมีการ execute code หรือเข้าถึงข้อมูล
AI Production System จึงไม่ใช่เพียง “เอาโมเดลขึ้น Server แล้วเปิด API”
แต่เป็นระบบ Software Engineering ขนาดใหญ่ที่ล้อมโมเดลเอาไว้อีกหลายชั้น
🏗️ 15. Training กับ Inference เป็นคนละโลก
เรามักพูดว่า “AI ใช้ GPU” แต่จริง ๆ ควรแยกสอง workload
Training
คือช่วงที่โมเดลเรียนรู้และปรับ Parameters
โดยทั่วไปต้องใช้
- Dataset ขนาดใหญ่
- Compute สูง
- GPU/Accelerator จำนวนมาก
- Distributed Training
- Checkpoint
- Storage throughput สูง
- Network bandwidth สูง
Training อาจใช้เวลานานและใช้ทรัพยากรอย่างมหาศาล
Inference
คือช่วงที่โมเดลที่ฝึกแล้วถูกนำมาใช้งานจริง
ทุกครั้งที่เราคุยกับ AI เรากำลังสร้าง Inference workload
ถ้ามีผู้ใช้งานระดับหลายร้อยล้านคน แม้ Request หนึ่งรายการดูเล็ก แต่เมื่อรวมกันแล้วจะกลายเป็นภาระ Compute มหาศาล
ดังนั้นเมื่อ AI เติบโต ปัญหาใหญ่ไม่ได้มีเพียง
“เราจะ Train โมเดลให้ฉลาดขึ้นอย่างไร?”
แต่รวมถึง
“เราจะ Serve โมเดลให้คนจำนวนมหาศาลใช้พร้อมกันอย่างไร โดยเร็ว เสถียร และต้นทุนเหมาะสม?”
⚡ 16. ปลายทางที่แท้จริงของ AI คือ “ไฟฟ้า”
เมื่อไล่ Stack ลงไปเรื่อย ๆ
Prompt
↓
Token
↓
Matrix Multiplication
↓
GPU
↓
Server
↓
Data Center
↓
ระบบระบายความร้อน
↓
ระบบไฟฟ้า
ท้ายที่สุด AI คือระบบที่นำ พลังงานไฟฟ้ามาเปลี่ยนเป็นการคำนวณ
Data Center สำหรับ AI ต้องรับมือกับความหนาแน่นของกำลังไฟที่สูงขึ้น และความร้อนจาก accelerator จำนวนมาก
จึงเกิดความสำคัญของเทคโนโลยีอย่าง
- Liquid Cooling
- Power Distribution
- UPS
- Backup Power
- ระบบบริหารพลังงาน
- ระบบเครือข่ายความเร็วสูง
- การออกแบบ Rack ความหนาแน่นสูง
การแข่งขัน AI จึงค่อย ๆ เชื่อมโยงไปถึงการแข่งขันด้าน พลังงานและโครงสร้างพื้นฐาน ด้วย
💰 17. Token คือหน่วยภาษา แต่ในอีกมุมมันคือหน่วยเศรษฐศาสตร์ของ AI
ทุก Token ที่ประมวลผลต้องใช้ Compute
ดังนั้นต้นทุน AI จึงสามารถคิดเชื่อมโยงได้กับ
จำนวน Token × ปริมาณการคำนวณ × ระยะเวลาการใช้ Hardware × ต้นทุน Infrastructure
นี่เป็นเหตุผลว่าทำไมอุตสาหกรรมจึงสนใจเทคนิคอย่าง
Quantization
ลด precision ของตัวเลขบางส่วนเพื่อประหยัด Memory และ Compute
Distillation
ถ่ายทอดความสามารถบางส่วนจากโมเดลขนาดใหญ่ไปยังโมเดลที่เล็กกว่า
Speculative Decoding
ใช้กลไกช่วยเสนอ Token ล่วงหน้าแล้วให้โมเดลหลักตรวจสอบ เพื่อเพิ่มความเร็วในบางสถาปัตยกรรม
Caching
หลีกเลี่ยงการคำนวณบางอย่างซ้ำโดยไม่จำเป็น
Model Routing
ไม่จำเป็นต้องส่งทุกคำถามไปยังโมเดลที่แพงที่สุด
การแข่งขันในอนาคตจึงไม่ได้วัดเพียง
Intelligence
แต่เป็น
Intelligence per Dollar
และในระดับโครงสร้างพื้นฐานอาจมองต่อไปถึง
Intelligence per Watt
🌎 18. หลังบ้าน AI จึงใหญ่กว่าตัว AI เอง
หากเรามอง AI เพียงหน้าต่าง Chat เราจะเห็นเพียง
Prompt → Answer
แต่หากเปิดหลังบ้านออก เราจะเห็น
Prompt
↓
Network
↓
API Infrastructure
↓
Authentication
↓
Safety System
↓
Model Router
↓
Inference Engine
↓
LLM
↓
GPU Cluster
↓
High-Speed Network
↓
Server Rack
↓
Cooling
↓
Power Infrastructure
↓
Data Center
และหาก AI ต้องทำงานกับโลกภายนอก ยังมี
Search Engine
Database
Vector Database
Cloud Storage
Enterprise Data
APIs
Software Tools
Agent Orchestration
เข้ามาอีกหลายชั้น
🔮 AI ในอนาคตอาจไม่ใช่ “โปรแกรม” แต่เป็นโครงสร้างพื้นฐาน
Internet เคยเปลี่ยนจากเทคโนโลยีใหม่ กลายเป็น Infrastructure ที่ธุรกิจแทบทุกประเภทใช้งาน
Cloud Computing ก็เดินเส้นทางคล้ายกัน
AI กำลังเดินไปในทิศทางเดียวกัน
ในอนาคตเราอาจไม่พูดว่า
“ธุรกิจนี้ใช้ AI หรือไม่?”
เพราะ AI จะกลายเป็นส่วนหนึ่งของ Software Stack ตามปกติ
คำถามที่สำคัญกว่าจะกลายเป็น
“ธุรกิจนี้ออกแบบระบบข้อมูล Workflow และ AI ให้ทำงานร่วมกันได้ดีเพียงใด?”
ผู้ชนะจึงอาจไม่จำเป็นต้องเป็นคนที่สร้าง Foundation Model ที่ใหญ่ที่สุด
แต่อาจเป็นคนที่รู้ว่า
จะนำ Model + Data + Tools + Workflow + Human Expertise มาประกอบกันอย่างไรให้เกิดคุณค่าจริง
💡 บทสรุป : หลังคำตอบหนึ่งประโยค มีโลกของวิศวกรรมซ่อนอยู่
ความมหัศจรรย์ของ AI ไม่ได้อยู่เพียงความสามารถในการเขียนข้อความเหมือนมนุษย์
สิ่งที่น่าสนใจกว่าคือ
หลังจากเรากด Send เพียงครั้งเดียว ระบบอาจต้องประสานงานระหว่าง Software หลายชั้น เครือข่ายความเร็วสูง หน่วยความจำ GPU โมเดลคณิตศาสตร์ ระบบค้นข้อมูล เครื่องมือภายนอก ระบบรักษาความปลอดภัย และ Data Center
ทั้งหมดเกิดขึ้นภายในเวลาเพียงไม่กี่วินาที
ดังนั้นครั้งต่อไปที่ AI พิมพ์คำตอบกลับมาว่า
“ได้ครับ ผมช่วยคุณได้”
สิ่งที่เราเห็นคือข้อความไม่กี่คำ
แต่สิ่งที่เกิดขึ้นเบื้องหลังคือการเดินทางจาก
ภาษา → Token → Vector → Transformer → GPU → Network → Data Center → Token → ภาษา
นี่คือเหตุผลที่ AI ไม่ควรถูกมองว่าเป็นเพียง Chatbot
แต่มันคือ Computing Stack รุ่นใหม่ ที่กำลังสร้างชั้นใหม่ขึ้นมาระหว่างมนุษย์ ข้อมูล และคอมพิวเตอร์
และบางที “การปฏิวัติ AI” ที่แท้จริงอาจไม่ได้อยู่ตรงหน้าจอที่เรากำลังมอง
แต่อยู่ใน หลังบ้านที่เราไม่เคยเห็น ต่างหาก
#AI #ArtificialIntelligence #DeepTech #LLM #Transformer #GPU #DataCenter #Technology #ThinkTong #บันทึกความคิดของคนชอบคิด
